自社で統制する
企業向けAI基盤
モデル・データ・コンピューティング資源を自社で統制する必要がある企業向けのAI基盤ソリューションです。
AppXcessは、企業のAIを支えるGPUコンピューティング、ストレージ、ネットワーク、配備基盤を設計・構築し、運用します。お客様のクラウド、自社データセンター、またはその両方にまたがって構築できます。容量やコスト、データレジデンシー規制のためにAI活用が制約され、チームがサーバー管理よりモデル開発に集中すべき組織のためのAI基盤構築サービスです。
統制を失わないAI配備
プライベートな隔離環境にモデルを配備し、ハードウェア、モデルの重み、入力データの所有権を完全に確保します。
パブリックAIプラットフォームのデータ漏えいリスクを回避できます。AppXcessなら、機微なデータとモデルの重みは安全なローカル隔離環境の中にとどまり、コンプライアンスと統制を完全に維持できます。
外部クラウドでホストされるパブリックモデルと、企業が自ら統制する隔離されたローカル環境を比較します。
企業のデータクエリがローカルのファイアウォールを越え、外部のサードパーティエンドポイントへ送信されます。共有サーバーが自社固有のモデルの重みをインデックス化し、知的財産の漏えいにつながります。
- ✗外部サーバー: データが企業のファイアウォールの外へ流出します。
- ✗共有される重み: サードパーティのモデルがクエリデータで学習します。
- ✗コンプライアンスリスク: 社内固有のワークロードが外部に露出します。
ローカルのモデルインスタンスが保護された境界レイヤーの内側で実行されます。厳格なアクセストークンがクエリの経路を検証し、モデルの重みを外部エンドポイントから隔離した状態に保ちます。
- ✓ローカル境界: データは100%プライベートなシステム内にとどまります。
- ✓モデルの所有権: モデルの重みは組織の資産です。
- ✓完全なコンプライアンス: 物理的な統制によりGDPR・SOC 2の要件を満たします。
プライベートLLM
エンタープライズ級の言語モデルを組織内のインフラだけに配備し、知的財産と業務インテリジェンスの所有権を完全に確保します。
↳ 機微なデータセットやコードベースが外部のパブリックベンダーへ漏えいすることを防ぎます。
プライベートAI基盤
完全に統制できるエンタープライズ級のプライベートAI環境を構築します。インフラ資産、モデルアーキテクチャ、機微な業務データベースの所有権を完全に維持します。
専用AI環境
組織のワークロードだけのために確保した完全に隔離されたコンピューティング環境で、他社とのリソース共有がありません。
インフラの所有権
物理的・運用的な統制を完全に維持しながら、ハードウェア設備を自社資産として計上し、減価償却できます。
プライベート配備
オフラインのモデルの重みを配備し、企業独自のセキュアなネットワークファイアウォールの内側で特化モデルをファインチューニングします。
セキュアな運用
全社的なデータ保護ポリシー、セキュアなネットワークアクセスキー、ハードウェアキーの検証を一貫して適用します。


ソブリンAI基盤
データレジデンシーと地域ごとのコンプライアンスを確実に担保します。厳格な地域規制とソブリンガバナンスモデルに従って、ローカライズされたAIノードを運用します。
データ主権
顧客のクエリとシステムデータが、定められた地域の境界内にとどまることを保証します。
地域コンプライアンス
国家セキュリティ指針、現地の規制、グローバルなデータ主権に関する法規に準拠します。
ローカルAI配備
すべてのAIワークロードをローカルで実行し、外部APIや海外クラウドへの依存をなくします。
統制されたガバナンス
アクセスプロトコル、システム監査ログ、データパイプラインに対する管理権限を提供します。
クロスクラウドAIオーケストレーション
主要なクラウドエコシステム全体でAIワークロードを配備・管理しながら、柔軟性、復元力、拡張性を維持します。
Amazon Web Services
カスタムのP4/P5 H100インスタンスを幅広く利用でき、S3データレイクと緊密に統合され、堅牢なIAMベースのID境界を提供します。
AppXcessのマネージドKubernetesとベアメタルのECSノードで、VPCを直接オーケストレーションします。
グローバルなトラフィックを処理する高性能な推論ルーティングと、大規模ベクトルデータベース。

AIコンピューティングクラスター
コンピューティング容量を必要に応じて動的に拡張します。複雑なAI処理に最適化した高性能なGPU・TPUノードで分散ワークロードを実行します。
GPUコンピューティング
相互接続されたGPUクラスター(NVIDIA H100/H200)で学習と推論を並列に実行します。汎用ハードウェアなら何日も順番待ちになるモデル作業も、ロードマップの計画どおりに進みます。
ストレージとデータスループット
高スループットのストレージが学習データをGPUに途切れなく供給するため、高価なコンピューティング資源が次のバッチを待って遊休状態になりません。
ネットワークとインターコネクト
ノードとリージョンを結ぶ低遅延でセキュアなリンクにより、分散したジョブが一つのクラスターのように動作します。より大きなモデルの学習を現実的に可能にする要素です。
拡張性
重要なワークロードに容量を割り当て、ジョブが終われば回収するため、ピークを基準に確保するのではなく、需要に応じてコストが発生します。
AI学習環境
モデル開発のサイクルタイムを短縮します。統合トラッキングコンソールを備えた高スループットのコンピューティング環境で、学習パイプラインを実行します。
モデルの学習とファインチューニング
言語モデルとビジョンモデルを、組織の境界内で自社のデータセットを使って学習・ファインチューニングするため、自社データがその境界を出ることはありません。
学習パイプライン
自動化されたスイープ、チェックポイント、重みのスナップショットにより、失敗した学習も最初からやり直すのではなく中断地点から再開でき、スケジュールとコンピューティング予算の両方を守れます。
データ処理
テキスト、画像、テレメトリのデータを収集・クレンジング・マッピングし、学習にすぐ使えるデータセットに整えます。学習のたびにデータ準備がボトルネックになることがなくなります。
実験トラッキング
すべての実行のデータ、パラメータ、結果を記録するため、本番稼働中のモデルがどのように作られたかを正確にたどれます。


モデル配備ハブ
開発段階のモデルを本番環境までシームレスに配備します。MLOpsの手法でリリースサイクルを自動化し、統合されたバージョン管理とともにベクトルホスティング基盤を拡張します。
LLM・モデルの配備
ローリングアップデート、カナリアリリース、自動チェックにより、サービスを止めることなく新しいモデルバージョンをユーザーに提供します。
ホスティング基盤
TritonやvLLMなどのエンジンをベースにしたサービングスタックで、モデルを自社インフラ上にホスティングし、外部APIのトークン単位のコストを回避します。
配備の自動化
Kubernetesワークロード、オートスケーリング、ロードバランシングを一度構成しておけば、リリースを毎回手作業で行うのではなく再現可能な形で運用できます。
バージョン管理とロールバック
稼働中の重みと構成を追跡するため、問題のあるリリースは本番でデバッグするのではなく数分でロールバックできます。
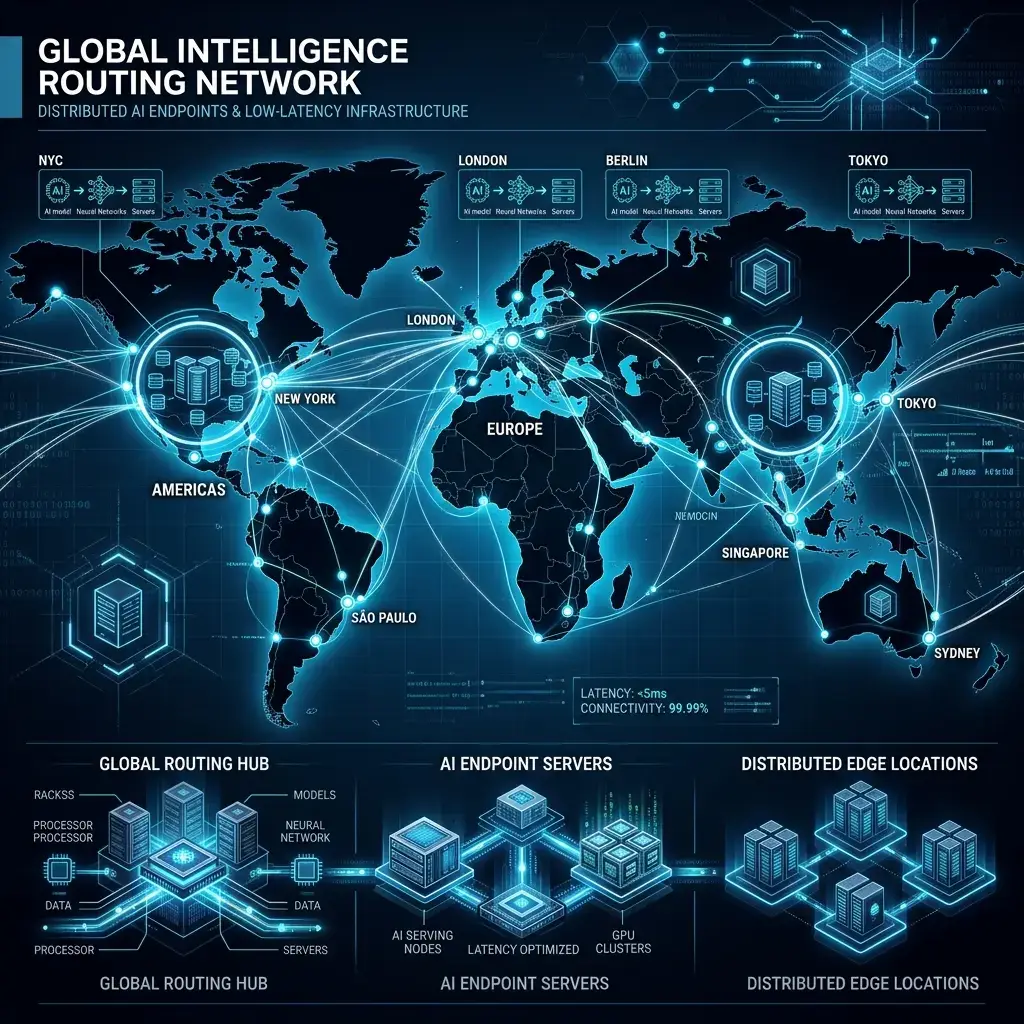
リアルタイム推論ネットワーク
モデルのエンドポイントを最小限の遅延で世界中に提供します。クエリのトラフィックを賢くルーティングし、システムのスループットと応答時間を最適化します。
低遅延の推論
ルーティング、キャッシュ、負荷分散を調整し、応答時間を安定して保ちます。AI機能を実際の業務プロセスの中で使えるものにする核心的な要素です。
リージョン別ルーティング
クエリは利用者に最も近いリージョンで処理され、組織のデータ規定が許可するリージョンの外に出ることはありません。
エンドポイント管理
エンドポイントの稼働状態、レート制限、APIゲートウェイを一元管理し、一つのチームが他のチームに必要な容量まで使い切ってしまわないようにします。
需要ピークへの対応
トラフィックをクラスター全体に分散し、利用が急増してもサービスが停止するのではなく、性能が緩やかに低下するようにします。

マルチクラウドオーケストレーション
複数のクラウド環境にまたがるワークフローをシームレスに調整します。統合された運用センターでリソース割り当てをオーケストレーションし、データベースを同期します。
AWS
SageMaker、コンピューティング・ストレージサービス、VPCルーティングを、独立したサイロではなく一つの管理環境の一部として運用します。
Microsoft Azure
AKSノードプール、Key Vault、Active Directoryを活用し、AIワークロードが組織で既に使っているIDとキー管理の仕組みをそのまま引き継ぎます。
Google Cloud
GKEクラスター、Vertex AIによるモデル追跡、TPU容量を活用します。Googleのアクセラレータでより高速に動作するワークロードに有用です。
DigitalOcean・プライベート環境
小規模なクラウド環境と自社データセンターも同じコントロールプレーンで管理し、コスト、容量、稼働状態を一か所で確認できます。

企業向けAIコンピューティング基盤
AIの学習・推論・モデル配備のパイプラインを高速に処理するよう最適化した、高性能なハードウェアクラスターです。
GPUクラスター
高スループットのAI学習・推論のために構築した、大規模並列のGPUクラスターです。
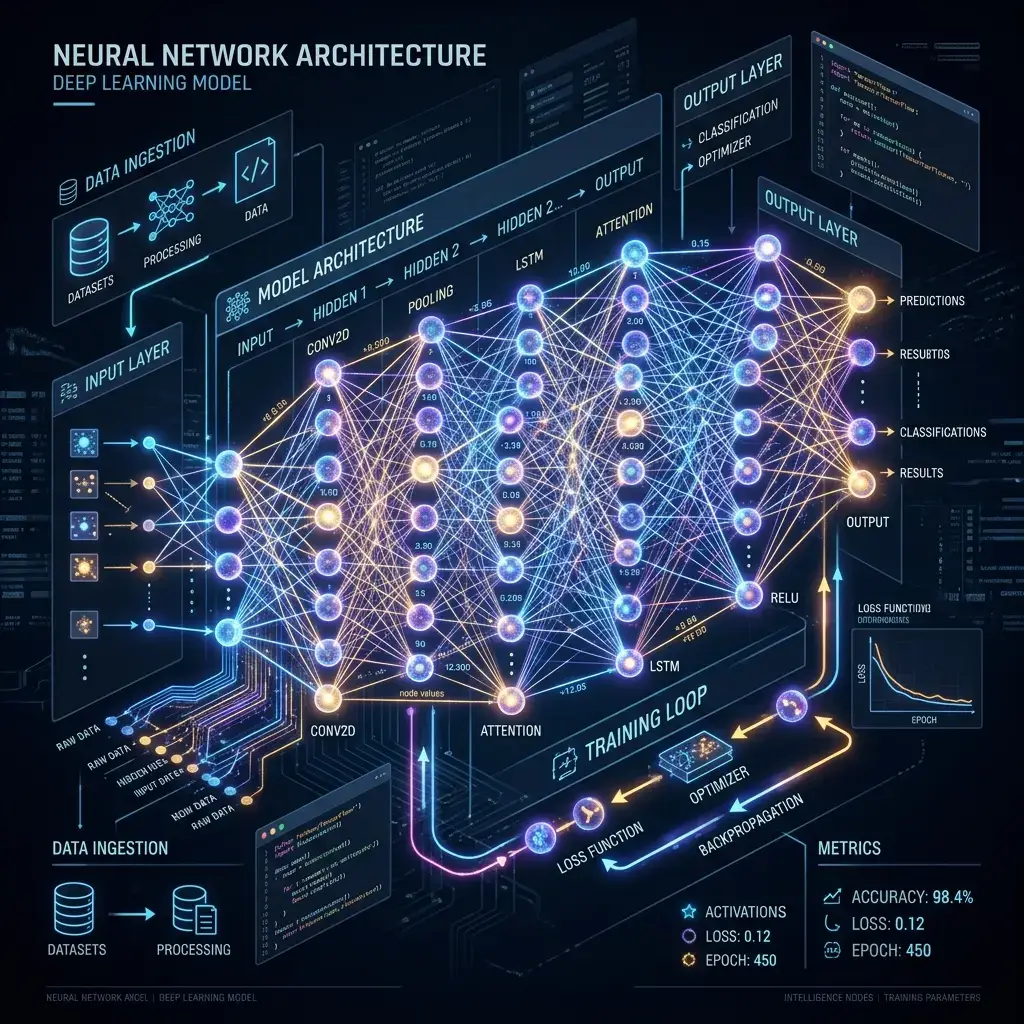
モデル学習
高度な重み最適化と高速化した学習パイプラインによる、大規模な分散学習です。
モデルホスティング
企業向けAIモデルのための、安全で拡張可能なコンテナレジストリと配備環境です。
推論プラットフォーム
リアルタイムAIアプリケーションのための、低遅延の分散推論環境です。
企業向けAIセキュリティ
ミッションクリティカルなAI導入のために設計したゼロトラストセキュリティ、暗号化、ガバナンスフレームワークで、モデル・データ・企業の業務を保護します。
グローバルなコンプライアンスと運用セキュリティの基準を満たしながら、機微な情報に対する統制を完全に維持します。
ゼロトラスト検証
すべてのアクセス要求を、権限を付与する前に継続的に検証します。
暗号化・キー管理
高度な暗号化とセキュアなキーボールトで企業データを保護します。
コンプライアンス・ガバナンス
中央集約型のガバナンスと監査対応可能な統制で規制基準を満たします。
企業セキュリティレイヤー
物理・デジタル両面のゼロトラスト境界を適用します。ハードウェアで隔離された環境とリアルタイムのセキュリティ態勢評価により、知的財産、モデルパラメータ、企業データベースを保護します。
インフラセキュリティ
暗号化されたIDキーとテナント間の遮断制御を備えた、物理施設・ハードウェアレベルの隔離を提供します。
エンドツーエンド暗号化
HSMキーモジュールにより、重要なモデルの重みとデータプールを転送中・処理中・保存中のすべての状態で安全に保護します。
ゼロトラストアクセス制御
厳格に定義した運用権限ポリシーにより、すべての業務環境のエンドポイントを継続的に検証します。
コンプライアンス管理
データ処理の流れを追跡する中央集約型のコンプライアンステレメトリ監査システムで、SOC 2とISO 27001の要件に対応します。

AI基盤スタック
セキュリティ、高スループットのコンピューティング、プライベートな重みの隔離、戦略的なビジネス統制のために設計した、相互に連携するレイヤー構造をご覧ください。
セキュリティレイヤー
レイヤー06ハードウェア隔離環境を備えたゼロトラストのアクセス境界。
マルチテナントのソブリンAI隔離と、HSMボールトのキー運用。
パイプラインの盗聴を遮断し、GDPRおよびSOC 2への準拠を確保します。
ハイブリッド導入環境
多くの企業には、一つの方式だけでは足りません。クラウドは変動が大きく一時的に集中する学習需要に適し、オンプレミスは外部に出せないデータや、自社で所有したほうがよい安定したワークロードに適しています。ハイブリッドは両方の環境を一つのコントロールプレーンで運用するもので、ほとんどのAIプロジェクトが最終的に行き着く形です。
クラウドインフラ
AWS、Azure、Google Cloud、DigitalOceanの容量を借りて使います。需要が一時的に急増し、たまにしか訪れないピークのためにハードウェアを購入したくない場合に最適です。
オンプレミスインフラ
自社のデータセンターで運用します。データレジデンシー、規制、機微性のためにデータを外部に出せない場合や、ワークロードが安定していてハードウェアを所有するほうが経済的な場合に最適です。
ハイブリッド運用
機微なデータと安定したワークロードは社内に置き、ピーク時にはクラウドへ拡張します。セキュアなリンクが二つの環境の間で処理をルーティングします。
統合管理
コンピューティングの割り当て、システムの稼働状態、コストを一つのダッシュボードで確認できるため、ハイブリッド環境でも運用モデルが二つに分かれることはありません。

プラットフォームの設計思想
すべての構築で、設計と規模の算定の基準にする特性です。目標値は一般的な数値として提示するのではなく、プロジェクトごとに実際のワークロードに基づいて合意します。
設計段階からのフェイルオーバー
冗長化したノードと自動フェイルオーバーを備え、可用性の目標は組織のサービス要件に合わせて設定します。
データに合わせて拡張
ストレージとスループットをデータセットの規模に合わせて算定し、学習データと利用量の増加に応じて拡張します。
標準で暗号化
モデルの重みとデータを保存時・転送中の両方で暗号化し、暗号鍵は組織が統制するハードウェアセキュリティモジュール(HSM)で保管します。
クラウド・ハイブリッド・オンプレミス
パブリッククラウド、ハイブリッド、オンプレミスの全体を一つのコントロールプレーンで管理します。

インフラ運用センター
中央のネットワーク運用コックピットから、システム性能をリアルタイムでモニタリングします。稼働中のGPU負荷、温度のしきい値、低遅延のAPI経路、コンテナのライフサイクルイベントを追跡します。
モニタリング
ノード、メモリ、ストレージ、電力使用量をリアルタイムで可視化し、容量の問題がプラットフォームを使うチームに影響する前に把握します。
リソース管理
クラスターを最も優先度の高い作業に割り当て、環境間でバランスを取ることで、重要なジョブが実験用の作業の後ろで待機しないようにします。
サービス可用性
フェイルオーバーシステムと自動復旧により、ハードウェア障害の間もサービスを維持します。可用性の目標は事前に組織と合意します。
コスト・容量の見直し
組織の実際の利用データから、遊休容量とボトルネックを特定します。インフラコストを削減できる余地は、たいていこの部分にあります。
AI基盤ロードマップ
企業の拡張マイルストーンを段階的に設計します。初期のプライベートGPUインフラの構築から、グローバルなマルチクラウドオーケストレーションを経て、完全に自律したプライベート隔離環境へと進みます。
ソブリンコンピューティング基盤の確立
ローカルのハードウェアクラスターを確保し、プライベートなモデルの重みをホスティングし、企業のファイアウォールの内側にゼロトラストのセキュリティレイヤーを適用します。
ハイブリッドネットワークの統合
AWS、Azure、GCPのリソースを統合し、コンテナオーケストレーションの自動化と、低遅延のグローバルなクエリルーティングを実現します。
認知型プラットフォームの拡張
リアルタイムの推論ネットワークを展開し、エネルギー指標を最適化し、マルチテナントのインフラ全体でエージェントを自律的に拡張します。
AI基盤を、
一緒に構築します
学習、推論、あるいは各チームが基盤として使うAIプラットフォームなど、運用したいワークロードと、データ・予算・スケジュール面の制約をお聞かせください。それらを基準にインフラの規模を算定し、運用に何が必要かをお示しします。