セマンティックインテリジェンス
同じ顧客、同じ部品、同じ契約でも、運用しているシステムごとに呼び名が異なります。そのため、誰かが間に立って一つひとつ突き合わせない限り、データはつながりません。セマンティックインテリジェンスは、データが何を意味し、どう関連し、どの用語が同じ対象を指すのかを記録します。これにより、アプリケーションは推測ではなく、こうしたつながりをもとに動作できます。
統一された用語体系
システムが違っても、用語ごとに合意された意味は一つです。
マッピングされた関係
レコードがどうつながるかを明示的に記録します。
移動しても失われない文脈
データがどこへ移っても、意味がそのまま付いて回ります。
企業データエコシステム
企業のデータはすでにどこかに保存されています。データレイク、ウェアハウス、ファブリック、メッシュのいずれか、あるいはその四つが同時に使われていることもあります。しかし、どの構成もデータが何を意味するかは教えてくれません。セマンティックAIは、どの構成を運用していても、その上でこの隙間を埋めます。検索ツールとは異なります。検索が文書を見つけるのに対し、セマンティックAIはその文書が何であり、何とつながっているかを説明します。
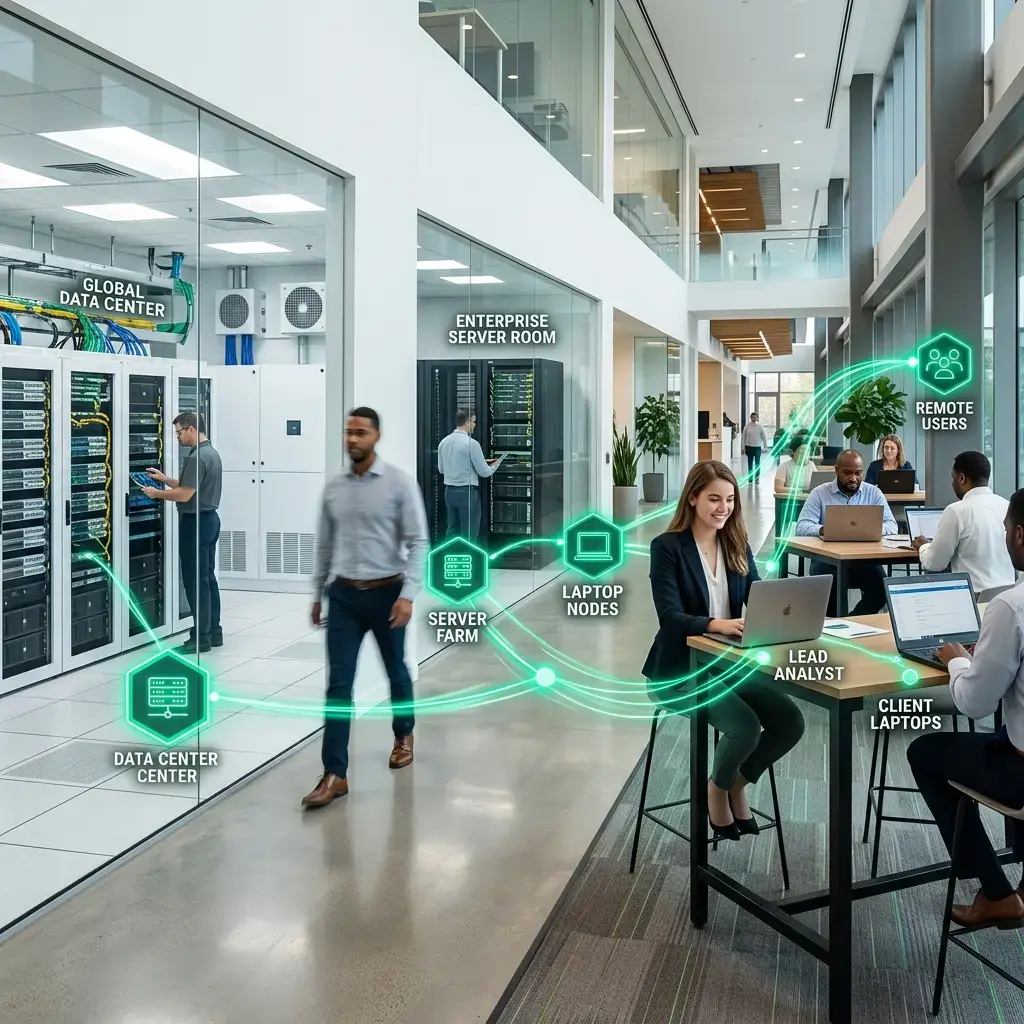
連携するシステム
ERP、CRM、クラウドストレージ、レガシーなネットワークシステムのディレクトリと直接連携します。
統合されたインテリジェンス
ユーザーのアクセス権限、レコード形式、メタデータスキーマを自動的に同期します。
説明の付いた一つのデータ目録
どのデータが存在し、何を意味し、どのチームが責任を持つのかを一か所にまとめます。
データソース連携、エンティティ抽出、各システムが保持するデータのカタログ化。
一部の担当者だけが知る暗黙知ではなく、説明の付いた一つの企業データ目録。
システムごとに異なる答えではなく、何が存在するかについての一つの説明。
データレイク全体に意味を与える
データレイクはすべてを保持しますが、何も説明しません。中身が何であり、どう関連するかを記述することで、単なる保管場所が、アプリケーションが推論できる対象へと変わります。
何が入っているか
レコード、文書、ログを、格納されたフォルダではなく、実際に表す対象に基づいて記述します。
どうつながっているか
ファイルと、それが属する顧客・プロジェクト・契約とのつながりを、推測ではなく記録します。
すぐ活用できる状態
チームごとに説明を作り直すのではなく、分析やAIアプリケーションが記録済みの説明をそのまま読み取ります。
データウェアハウスのレポーティングに文脈を
データウェアハウスは整ったテーブルを提供します。しかし、この売上カラムとあの売上カラムが同じ意味かどうかは教えてくれません。二つの正確なレポートでも数値が食い違いうるのは、このためです。
構造化データインテリジェンス
定義された用語をテーブルとともに管理するため、カラムには名前だけでなく意味と担当者が備わります。
ビジネスレポーティング
定義された用語をもとに作成したレポートは、数値の裏付けとなる定義が同じため、互いに整合します。
リレーショナルテーブルのインデックス化、最適化されたパーティションクエリエンジン、トランザクション監査。
形式が整えられた企業レコードのデータベース、統合されたビジネスレポート。
レポートの裏付けとなる用語が一致するため、レポートも互いに一致します。
データファブリック全体の関係
データファブリックは、もともと連携するように設計されていないシステム同士をつなぎます。しかし、それらのシステムが使う用語を突き合わせることは、ファブリックだけではできません。ここで意味レイヤーが力を発揮します。
システムを越える用語
レコードがCRM、ERP、地域別データベースのどこから来ても、同じ定義が適用されます。
途切れないつながり
一度記録した関係は、その下のソースシステムが入れ替わっても維持されます。
用語ごとの担当
定義ごとに責任を持つチームがいるため、変更は勝手に進むのではなく、提案とレビューを経て行われます。
データメッシュにおける共通の意味
データメッシュは、ドメインごとに自らのデータの所有権を与えます。この方式は、各ドメインが共通用語の意味に合意して初めて機能します。セマンティックレイヤーは、まさにこの合意を明示し、指名された担当者が責任を負うよう管理します。
財務ドメイン
ドメイン主導の元帳処理、請求書の自動チェック、取引テレメトリ。
財務部門がすでに従っている会計基準と通貨表記の慣行に合わせた定義。
元帳の項目が、突き合わせ対象のレコードと同じ意味を持ちます。
分散ドメインリポジトリのレジストリ、スキーマ準拠の自動チェック。
ドメインごとに独立したデータベースの所有権、中央化されたスキーマディレクトリ。
各ドメインは所有権を保ちながら、共通の用語で意思疎通します。
セマンティックインテリジェンス
セマンティックレイヤーは、構築した後も継続して維持・管理していく対象です。合意された用語体系(オントロジー)、レコード間の関係を示したマップ、そしてこの二つが部門を越えて成り立つように支える文脈で構成されます。
合意された定義
各用語の意味と担当チームを文書化し、財務・オペレーション・営業が同じ言葉を三つの異なる意味で使うことをなくします。
記録された関係
顧客・プロジェクト・運用ログが実際にどうつながるかを記録し、人が毎回つながりを見つけ直す代わりに、ソフトウェアがそのつながりをたどれるようにします。
生データから引き出す意味
テーブル名、コード、ファイル構造を、現場がすでに使っている用語に置き換え、会社が実際に業務を語る言い方をモデルに反映させます。
同義語の自動マッピング、エンティティ抽出ネットワーク、文脈意図のデコーダー。
統合されたリレーショナルスキーマ、組織ノードのセマンティックカタログ。
同じ用語は、それを使うすべての部門で同じ意味を持ちます。
ナレッジグラフで記録する関係モデル
ナレッジグラフは、こうした関係を書き留めておく場所です。たとえば、この請求書はどのサプライヤーのもので、どの契約に基づき、どのチームが担当するのか、といったことが記録されます。すると検索はもちろん、ほかのどんなアプリケーションもこのつながりをたどれます。
エンティティと担当者
顧客・契約・部品が何であるかを定義し、その定義をどのチームが担うかを定めます。
レコード間のつながり
どのレポートがどのプロジェクトを裏付けるかを記録し、一方への問いがもう一方まで届くようにします。
つながりを取り巻く文脈
つながりごとに、いつ・どこで・誰のものかを併せて残し、後から見てもその意味が分かるようにします。
関係パス、複数エンティティのマッピング、システム間の同義語解決。
必要とするどのアプリケーションからも利用できる、レコード間の関係のディレクトリ。
関連するレコードを一つずつ探す代わりに、まとめて浮かび上がります。
ベクトルデータベース
グラフは名前を付けられる関係を記録します。ベクトルインデックスは名前を付けられない関係、たとえば同じ対象を異なる言葉で扱う二つの文書の関係を捉えます。二つを組み合わせると、アプリケーションは定義済みのつながりと類似性の両方を活用できます。
記録された類似性
コンテンツを扱う主題に基づいて格納するため、同じ主題の資料は、言葉が重ならなくても互いに近くに置かれます。
見えていなかったつながり
当時は誰も相互参照しようと思わなかった関連規程、過去の設計、類似事例を見つけ出します。
アプリケーションの根拠
質問に関わる具体的なレコードをAIアプリケーションに与え、モデルが記憶している内容ではなく、自社の資料に基づいて答えられるようにします。
類似度しきい値シミュレーター
類似度しきい値の設定によるトレードオフを示す例です。実際の件数は、保有するコンテンツによって変わります。
類似したコンテンツを近くに配置する埋め込みと、それを説明するカタログ。
アプリケーションは、単語が一致するものだけでなく、これに似ているものは何かを問えます。
回答を、その根拠となったレコードと関係まで遡って確認できます。
セマンティックインテリジェンスとエンタープライズ検索AI
エンタープライズ検索AIは、質問するその瞬間を担います。誰かに知りたいことがあり、その答えを取ってこなければならないときです。セマンティックインテリジェンスは、その下で動く意味モデルであり、人が直接照会する対象ではありません。検索は項目を見つけ、セマンティックレイヤーは項目と項目のつながりを何かがたどれるようにします。
どちらが必要か
検索は見つける
誰かが文書や特定の一節を必要とするときです。これがエンタープライズ検索AIであり、人が直接使う道具です。
モデルは関係づける
ある契約が、どの規程のもとでどのサプライヤーに属するかをアプリケーションが知る必要があるときです。このモデルは一度構築して繰り返し使います。
組み合わせるとより良く働く
その下にある用語と関係がすでに合意・記録されていると、情報の取得精度が高まります。
エンティティの定義、関係マップ、ドメインごとに合意された用語体系。
検索・分析・AIアプリケーションのすべてが参照できる一つのモデル。
結局は同僚にありかを尋ねて終わる検索が減ります。
セマンティックインテリジェンスが効果を発揮する領域
共通の意味レイヤーがないために、実際に時間が失われている三つの場面です。上のセクションで示した、知的なデータ関係と文脈を踏まえた企業アプリケーションを可能にするのも、この同じモデルです。
知識探索
課題:答えはすでにあるのに、その質問と結びつけて考える人がいなかった文書の中にあります。関係が記録されていれば、関連する規程、過去のプロジェクト、担当チームが一緒に浮かび上がります。
文書の理解
課題:契約書は、誰かが読むまではただのファイルです。契約当事者・日付・義務をエンティティとして記述すれば、保管されるだけのファイルではなく、システムが処理できる対象になります。
意思決定支援
課題:二つのレポートの数値が食い違うのは、その裏付けとなる用語の定義が異なるためです。定義が合意されていれば、数値は会議中ではなく会議前に一致します。
エンティティの定義、関係のマッピング、用語ごとの担当者責任。
推測する代わりにモデルを参照する、文脈を踏まえたアプリケーション。
会議で定義を擦り合わせる代わりに、すべてのチームが同じ定義をもとに働きます。
セマンティックAIアーキテクチャ
セマンティックレイヤーが位置する場所は、データソースの上、アプリケーションの下、そして各定義の担当者を定めるガバナンスの中です。
すでに運用しているデータソースから出発し、その上に何かを構築する前に、各ソースが実際に何を保持しているかを記述します。
リアルタイムのデータベースクエリ、統合されたファイル取り込みAPI、メタデータスクレイパー。
統合されたレコードプール、システムへの直接コネクタ、生スキーマのカタログ。
データソース連携、スキーマと照合した定義の点検、変更レビュー。
所有権とレビュー履歴が併せて記録された、説明の付いたデータ基盤。
各レイヤーに説明が備わっているため、上のレイヤーは下のレイヤーの意味を信頼して活用できます。
セマンティックインテリジェンスに関するFAQ
セマンティックインテリジェンスは、企業データに意味を与えるレイヤーです。各対象が実際に何であるか、何と関連するか、あるシステムのどの用語が別のシステムのどの用語と同じ意味かを記録します。これにより、ソフトウェアはすべてのレコードを孤立したファイルとして扱うのではなく、情報同士のつながりをもとに動作できます。
どこでも同じ意味で通じるデータへ
同じ対象がシステムごとにどんな異なる名前で呼ばれているか、その不一致がどんなコストを生んでいるかをお聞かせください。セマンティックAIのプロジェクトは小さく始めます。まず、モデリングする価値のある用語と関係を絞り込んで範囲を定めます。
セマンティックレイヤーは、データが何を意味するかを記述します。エンタープライズ検索AIはそれを使って情報を見つけ、エンタープライズインテリジェンスはそれを使ってデータを分析します。データ・AIはその下のパイプラインとプラットフォームを構築し、AIソリューションはその上にカスタムアプリケーションを構築する領域です。